Het verschil tussen een klassieke zoekmachine en een answer engine
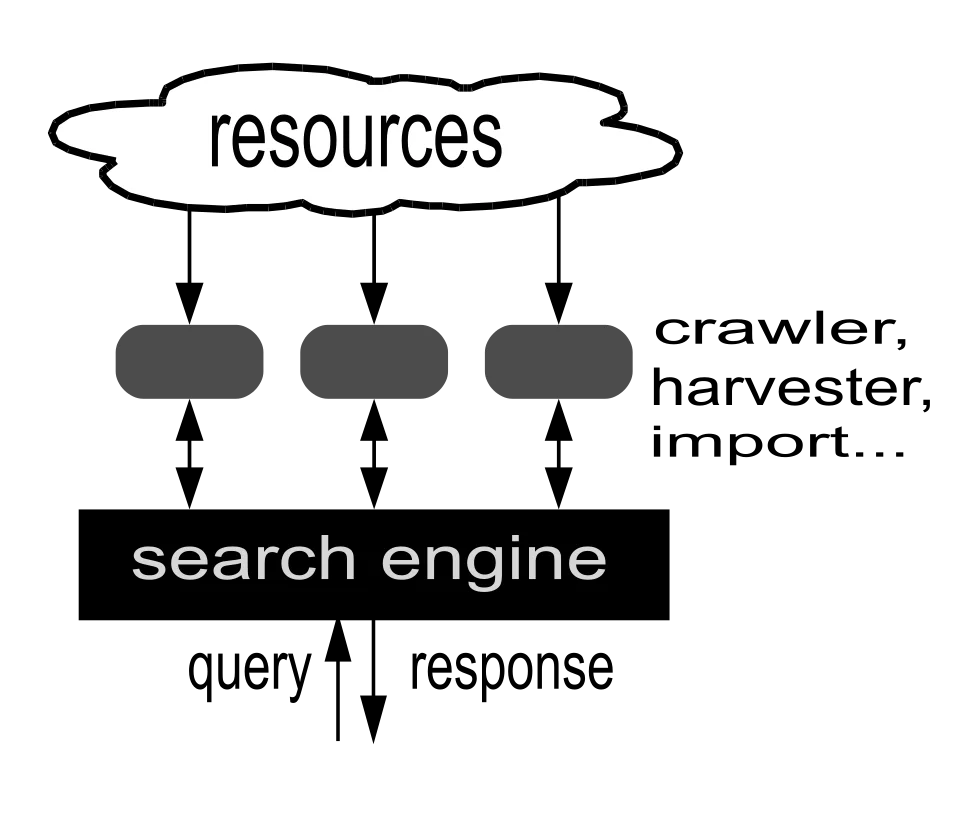
Een klassieke zoekmachine als Google doorzoekt een eigen index en toont een gerangschikte lijst van pagina's die bij de zoekopdracht passen; de gebruiker kiest zelf welke link hij opent. Een answer engine, zoals ChatGPT, Perplexity of Google AI Overviews, doet iets fundamenteel anders: het stelt op basis van de vraag één gesynthetiseerd antwoord samen, vaak in de vorm van een alinea, een vergelijking of een genummerde lijst, gedestilleerd uit meerdere bronnen tegelijk.
Die bronnen komen niet uit het geheugen van het taalmodel alleen. De meeste moderne AI-chatbots combineren hun getrainde kennis met live opgehaalde webinformatie, een techniek die bekendstaat als retrieval augmented generation. Het model haalt op het moment van de vraag actuele pagina's op, leest de relevante fragmenten, en verwerkt die in een lopend antwoord met bronvermelding.
Crawling: hoe AI-systemen uw site vinden
Voordat een AI-systeem uw content kan citeren, moet het die eerst kunnen lezen. Daarvoor gebruiken de grote spelers eigen crawlers, vergelijkbaar met de Googlebot die al decennia rondgaat voor de klassieke zoekresultaten:
- GPTBot en OAI-SearchBot van OpenAI
- ClaudeBot van Anthropic
- PerplexityBot van Perplexity
- Google-Extended, de crawler die Google gebruikt om content specifiek voor AI-training en AI-antwoorden te verzamelen, los van de reguliere Googlebot
Als uw robots.txt deze crawlers blokkeert, sluit u zichzelf potentieel uit van vermelding in AI-antwoorden. Controleer daarom periodiek uw serverlogs op bezoeken van deze user-agents; een toename in verkeer van GPTBot of PerplexityBot is een concreet signaal dat AI-systemen uw site actief meenemen.
Hoe elk platform bronnen weegt
Niet elk systeem citeert dezelfde bronnen even zwaar, en dat verschil is relevant voor waar u zich op richt:
- ChatGPT leunt relatief sterk op Wikipedia en Reddit, naast reguliere webresultaten.
- Claude beloont in de praktijk vaker lange-vorm, analytische content van een genoemde, herkenbare auteur.
- Gemini en Google AI Overviews bouwen voort op Google's bestaande zoekindex, aangevuld met YouTube en Reddit.
- Perplexity geeft in veel categorieën voorrang aan gevestigde nieuwsbronnen zoals persbureaus en gerenommeerde vakmedia.
Deze verschillen verklaren waarom een pagina die goed scoort in de klassieke Google-resultaten niet automatisch ook wordt geciteerd door elke AI-chatbot. Onderzoek uit 2026 laat zien dat slechts ongeveer 44% van de pagina's in Google's top tien ook daadwerkelijk terugkomt in minimaal één AI-gegenereerd antwoord; ranking en citatie zijn losgekoppeld geraakt van elkaar.
Wat AI-systemen doen nadat ze uw pagina hebben opgehaald
Na het ophalen van een pagina breekt een AI-systeem de tekst doorgaans op in kleinere, doorzoekbare fragmenten, en beoordeelt per fragment hoe goed dat aansluit bij de gestelde vraag. Fragmenten met een duidelijke, op zichzelf staande kernzin worden makkelijker herkend en overgenomen dan lange alinea's waarin het antwoord pas na meerdere zinnen duidelijk wordt. Dat is ook de reden waarom contentstructuur zo'n grote rol speelt in GEO: hoe concreter en losser te lichten een stuk tekst is, hoe groter de kans dat het letterlijk in een antwoord terechtkomt. Praktische richtlijnen daarvoor staan in content structureren zodat AI-chatbots u citeren.
Marktaandeel en gebruik in 2026
De verdeling tussen de grote AI-systemen verschuift voortdurend. In meetbare B2B-verwijzingen daalde het aandeel van ChatGPT in 2026 naar ongeveer 62,6%, terwijl Claude rond 18,5% haalde, Gemini circa 10,6% en Perplexity ongeveer 7,3%. Qua absolute gebruikersaantallen trekt ChatGPT met naar schatting 5,8 miljard maandelijkse bezoeken nog altijd het grootste publiek, tegenover ongeveer 1,8 miljard voor Gemini. Voor uw zichtbaarheidsstrategie betekent dit dat ChatGPT doorgaans het grootste bereik oplevert, maar dat platformen als Perplexity en Claude voor specifieke doelgroepen, zoals onderzoekend of analytisch publiek, relatief zwaarder kunnen wegen dan hun marktaandeel doet vermoeden.
Waarom sommige AI-antwoorden geen bronnen tonen
Niet elk AI-antwoord vermeldt expliciet waar de informatie vandaan komt. Wanneer een taalmodel een vraag beantwoordt puur uit zijn getrainde kennis, zonder een live zoekactie uit te voeren, ontbreekt een citatie simpelweg omdat er geen actuele bron is geraadpleegd. Dat gebeurt vaker bij algemene, weinig tijdgevoelige vragen dan bij vragen over actuele cijfers, prijzen of recente gebeurtenissen, waarbij de meeste systemen wél een live zoekactie starten. Voor GEO is dit onderscheid relevant: content die inspeelt op actuele, veranderlijke informatie heeft meer kans om een live retrieval-stap te triggeren, en daarmee meer kans om als bron te worden opgehaald en genoemd, dan content die aansluit bij algemene kennis die het model toch al 'uit het hoofd' kent.
Wat dit betekent voor de opbouw van uw site
Omdat AI-crawlers content per pagina en per fragment beoordelen, telt de technische toegankelijkheid van uw site zwaarder dan bij klassieke SEO vaak wordt aangenomen. Zorg dat kernpagina's niet afhankelijk zijn van JavaScript om hun tekst te tonen, aangezien niet elke AI-crawler scripts even volledig uitvoert zoals een moderne browser dat doet. Houd laadtijden laag en vermijd onnodige omleidingen, omdat een crawler met een beperkt tijdsbudget per bezoek anders voortijdig kan afhaken voordat de relevante content is bereikt. Een heldere interne linkstructuur helpt bovendien niet alleen menselijke bezoekers, maar ook crawlers om van de ene naar de andere relevante pagina te navigeren binnen hetzelfde bezoek.