Wat is structured data en waarom vraagt u er nu meer aandacht voor?
Structured data is gecodeerde informatie die u aan een pagina toevoegt zodat zoekmachines en AI-systemen exact begrijpen waar de tekst over gaat: is dit een recept, een product, een vacature, een artikel van een specifieke auteur? Zonder die markup moet een crawler of taalmodel dat uit lopende tekst afleiden, met kans op misinterpretatie. Met markup krijgt u een gestructureerde, machineleesbare laag onder uw pagina, los van hoe de pagina er visueel uitziet.
Het belang hiervan is in 2026 verschoven. Een aantal jaren geleden ging het vooral om rich results in Google: sterren bij een productrecensie, een FAQ-uitklapper onder een blauwe link. Google heeft op 7 mei 2026 de FAQ-rich results uit de reguliere zoekresultaten gehaald en ook de HowTo-rich results zijn op mobiel grotendeels verdwenen. De visuele beloning in de SERP is dus kleiner geworden voor die twee types. Tegelijk is het belang van structured data voor AI Overviews, ChatGPT en Perplexity juist gegroeid: deze systemen gebruiken schema.org-markup om passages te identificeren, te extraheren en te citeren.
De verschuiving betekent niet dat u minder aan structured data hoeft te doen, eerder integendeel. Waar een rich result vroeger het enige zichtbare rendement was, is de markup nu ook een manier om te bepalen of uw pagina in aanmerking komt als bron voor een AI-gegenereerd antwoord. Een pagina zonder duidelijke markup moet volledig op basis van lopende tekst geïnterpreteerd worden, en dat is nu eenmaal foutgevoeliger dan een expliciet gecodeerd signaal.
Welke schema.org-types zijn in 2026 nog relevant?
Product-schema in combinatie met AggregateRating is een van de weinige rich-result-types die in 2026 nog consistent sterren oplevert in de zoekresultaten, en blijft dus de moeite waard voor webshops. Voor content-sites en kennisplatforms liggen de prioriteiten anders:
- Article — geeft AI Overviews en Google een duidelijk signaal over auteur, publicatiedatum en onderwerp van een artikel.
- Person — een profielpagina met Person-schema voor elke auteur; Google gebruikt dit direct om auteursgeloofwaardigheid te beoordelen, een signaal dat meeweegt in contentkwaliteit en E-E-A-T.
- Organization — bedrijfsgegevens, logo en social profiles op een centrale plek.
- BreadcrumbList — toont de navigatiestructuur in de zoekresultaten en helpt crawlers de site-hiërarchie te begrijpen.
- FAQPage en HowTo — leveren geen fancy rich result meer op, maar voeden nog altijd de modellen die bepalen of een pagina geciteerd wordt.
- LocalBusiness — essentieel voor bedrijven met een fysieke locatie of servicegebied.
De praktische conclusie: schema toevoegen blijft zinvol, ook wanneer het geen visuele rich result meer oplevert. Het gaat inmiddels evenzeer om AI-citaties als om sterretjes in de SERP.
Waarom is JSON-LD de aangewezen vorm?
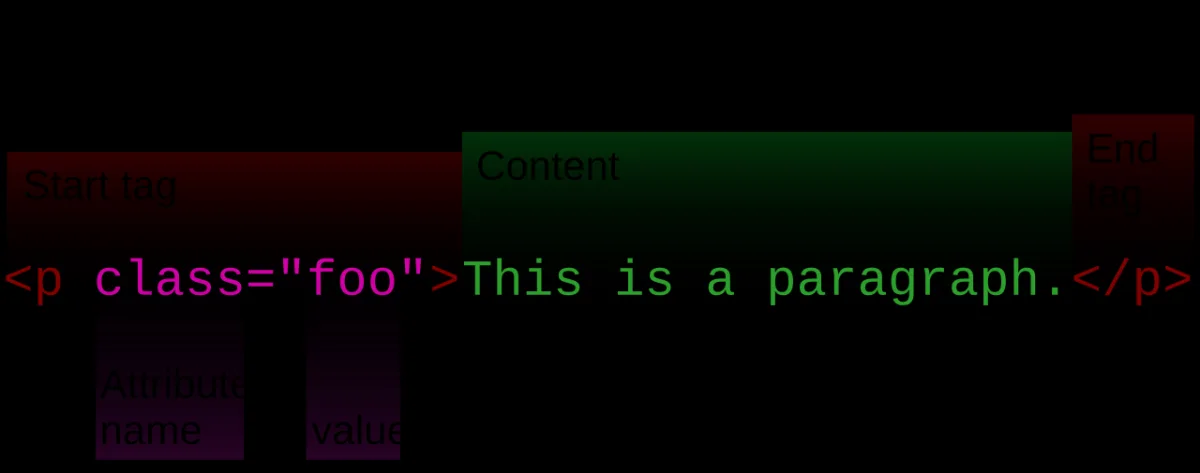
JSON-LD staat los van de zichtbare HTML en wordt als los blokje code in de pagina geplaatst, meestal in de head of vlak voor de sluitende body-tag. Dat maakt het de meest onderhoudsvriendelijke manier om structured data te implementeren, in tegenstelling tot microdata of RDFa, waarbij de markup verweven zit in de zichtbare HTML-elementen zelf.
Google, Bing, Perplexity en ChatGPT gebruiken allemaal JSON-LD als voorkeursformaat om gestructureerde signalen van een pagina te lezen. Voor een site die zowel op klassieke zoekresultaten als op vermeldingen in AI-antwoorden wil scoren, is JSON-LD dus geen keuze meer maar een basisvereiste.
Hoe voegt u JSON-LD toe aan een pagina?
Een minimale Article-markup ziet er als volgt uit:
- Open een `<script type="application/ld+json">`-blok.
- Vermeld `@context`: `https://schema.org` en `@type`: `Article` (of het relevante type).
- Vul verplichte velden in: `headline`, `author` (bij voorkeur verwijzend naar een Person-object met `url`), `datePublished`, `dateModified` en `image`.
- Voeg waar relevant `publisher` toe met naam en logo.
- Sluit het script-blok af en test de pagina.
Voor productpagina's voegt u daarnaast `offers` (prijs, valuta, beschikbaarheid) en, indien u reviews verzamelt, `aggregateRating` toe. Test elke implementatie met de Rich Results Test van Google en met een schema-validator, en controleer in Search Console onder Verbeteringen of er handmatige acties of waarschuwingen verschijnen nadat de markup live staat.
Bij een groter platform met tientallen of honderden pagina's is het onpraktisch om elk JSON-LD-blok met de hand te schrijven. Genereer de markup in dat geval automatisch vanuit het onderliggende systeem: een CMS of eigen sjabloon kan velden als auteur, publicatiedatum en afbeelding rechtstreeks uit de bestaande database vullen. Zo blijft de markup automatisch synchroon met de zichtbare content, in plaats van een los onderhouden kopie die na verloop van tijd uit de pas gaat lopen.
Hoe gebruiken AI-chatbots structured data om te citeren?
AI Overviews, ChatGPT en Perplexity bouwen hun antwoorden op door passages uit meerdere bronnen te combineren, en gebruiken structured data om sneller te bepalen welke passage bij welke vraag hoort. Een Article met een heldere `headline`, een correcte `datePublished` en een gekoppeld Person-object voor de auteur geeft een taalmodel een aanwijzing over actualiteit en herkomst die uit lopende tekst alleen lastiger te destilleren is.
Dit werkt vooral in combinatie met goed gestructureerde koppen en zelfstandige alinea's in de zichtbare tekst zelf: markup is een aanvulling op heldere content, geen vervanging ervan. Een pagina met sterke JSON-LD maar rommelige, vage lopende tekst wint weinig, omdat het taalmodel uiteindelijk toch de leesbare tekst citeert, niet de markup zelf. Zorg dus dat beide lagen — de zichtbare tekst en de gecodeerde markup — dezelfde boodschap vertellen.
Veelgemaakte fouten bij het toevoegen van structured data
De meest voorkomende fout is markup die niet overeenkomt met de zichtbare inhoud van de pagina: een FAQPage-schema met vragen die nergens in de tekst staan, of een AggregateRating zonder zichtbare reviews. Dit soort mismatches beschouwt Google als misleidend en kan leiden tot het negeren of zelfs bestraffen van de markup.
Andere veelgemaakte problemen:
- Verplichte velden overslaan, waardoor de validator de markup afkeurt.
- Meerdere conflicterende schema-blokken op één pagina (bijvoorbeeld twee Article-objecten).
- Schema kopiëren van een sjabloon zonder de waarden aan te passen aan de specifieke pagina.
- Vergeten de markup te updaten wanneer de content wijzigt, waardoor `dateModified` niet meer klopt.
- Een verkeerd of te generiek schema-type kiezen, bijvoorbeeld `Thing` gebruiken waar een specifieker type als `Product` of `Recipe` beschikbaar is en veel meer signaal geeft.
Controleer daarom periodiek, bijvoorbeeld elk kwartaal, of de markup nog aansluit bij de actuele inhoud van uw belangrijkste pagina's. Neem dit standaard op in het onderhoudsproces van de site, net zoals u een technische controle op broken links of laadtijd zou inplannen: structured data is geen eenmalige implementatie maar een onderdeel dat meegroeit met de content.